Mis Proyectos
1.
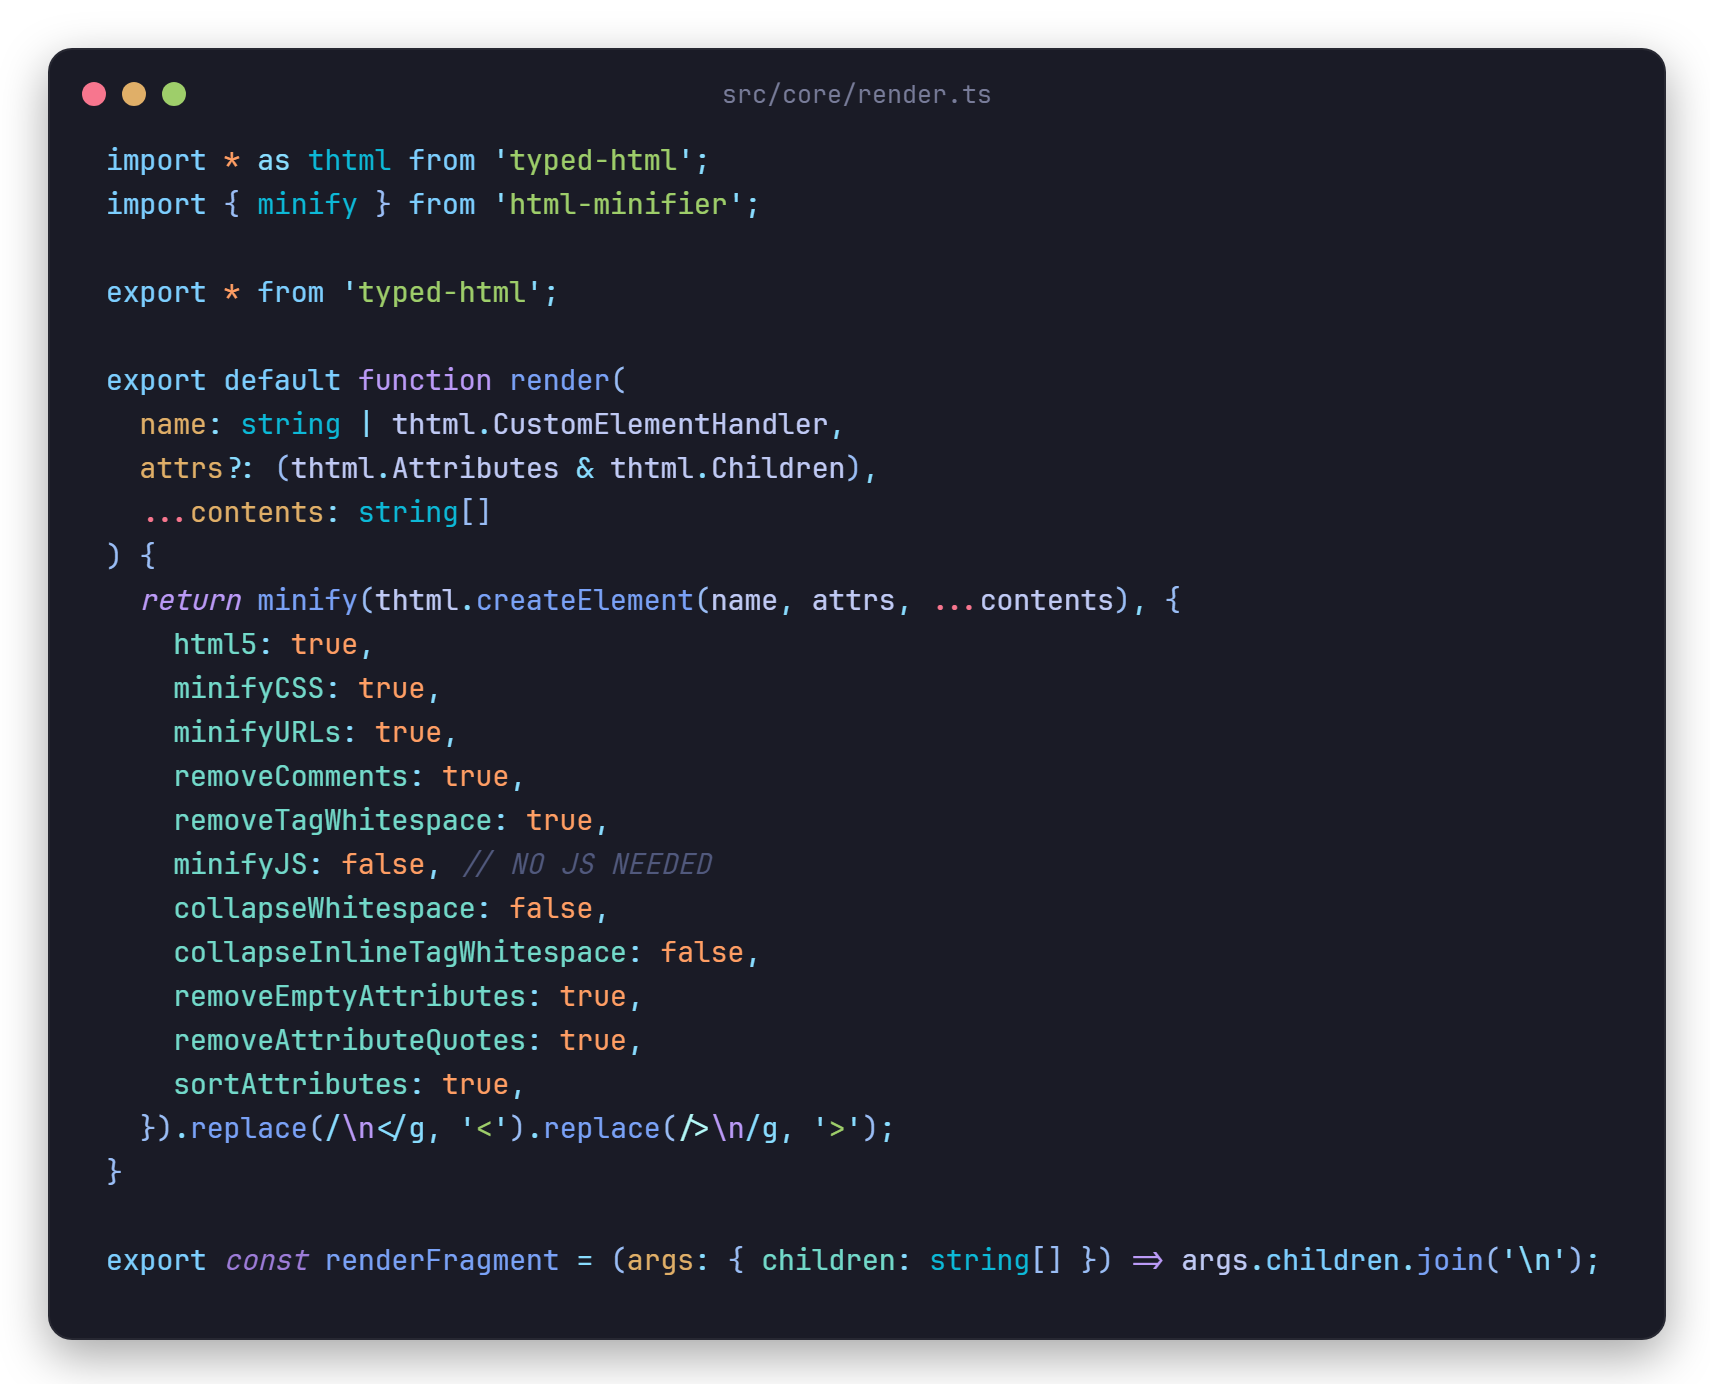
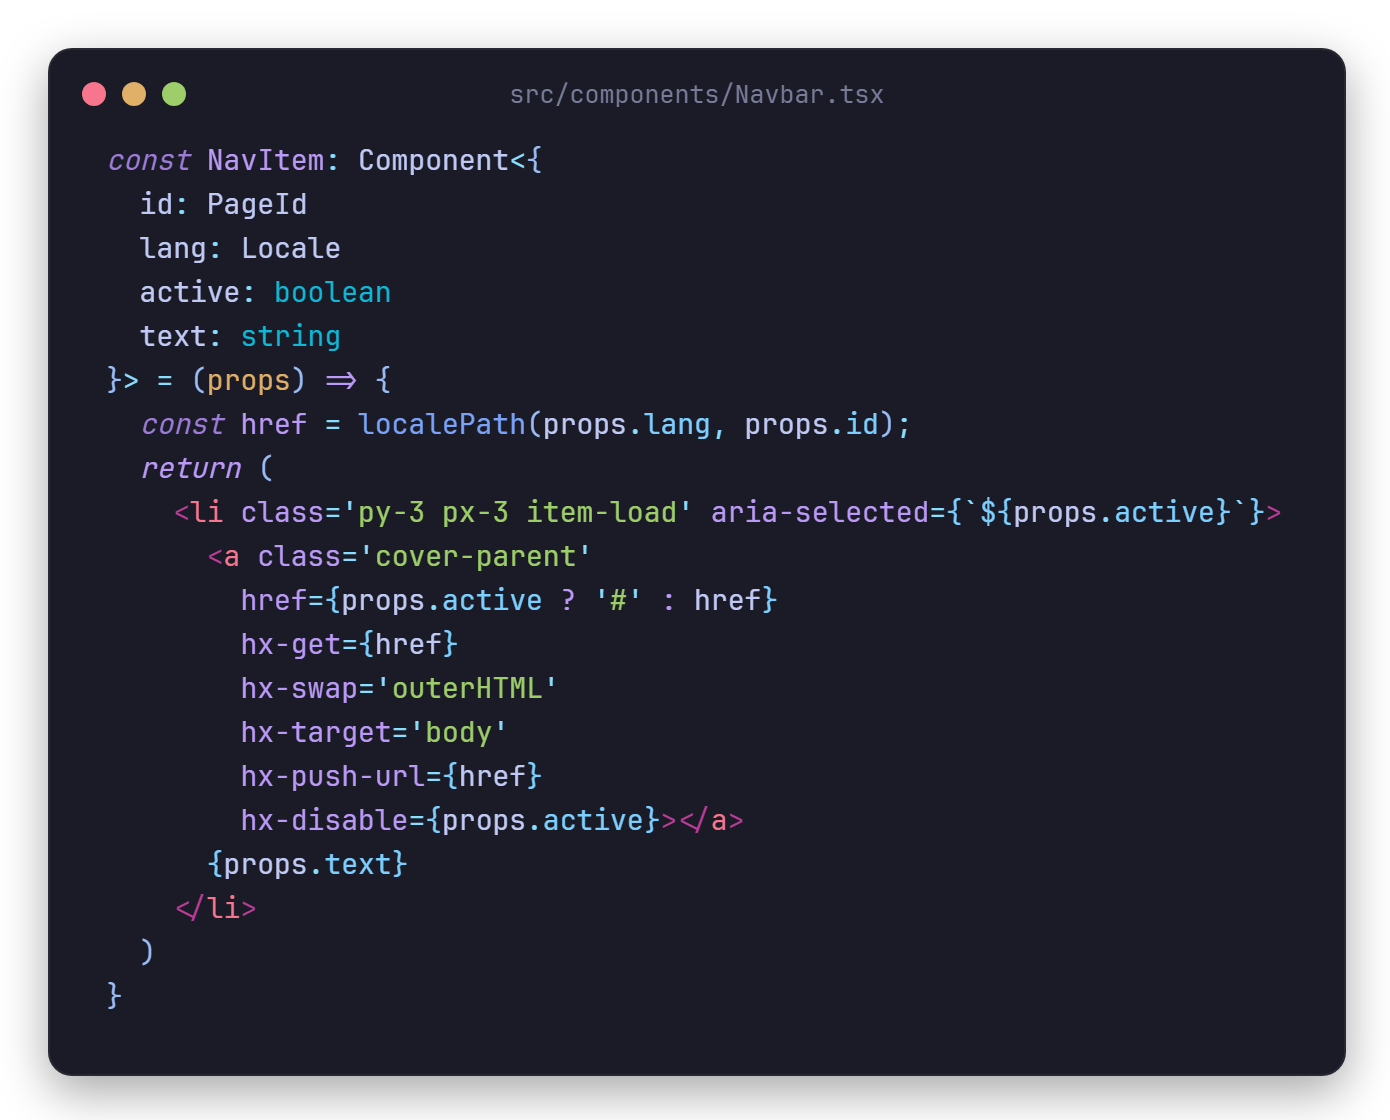
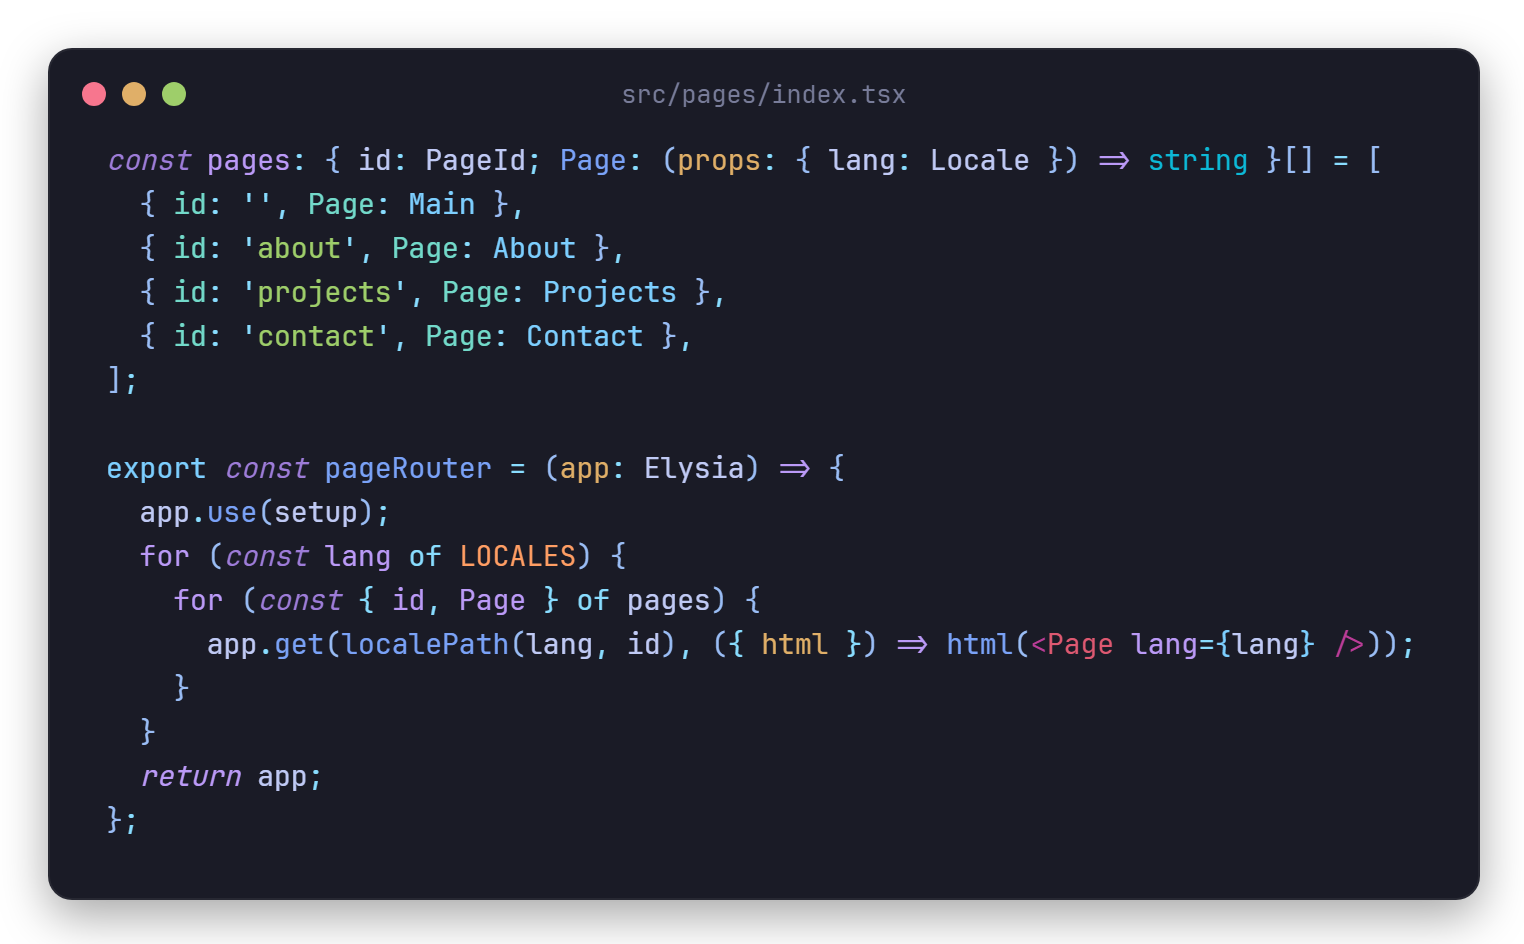
Este portafolio es un proyecto en TypeScript puro. No se usó ningún framework de front-end. Es un proyecto full-stack basado en servidor que usa Elysia.js, el renderizador de HTML del framework, y HTMX para las interacciones en el front-end.
¡Para cuando llegaste hasta aquí, no deberías haber recibido ni 80 kilobytes de JavaScript!
Toda la interactividad y la simulación de Single Page App se logra mediante el mecanismo de swap de HTMX, que, usando los parámetros recolectados en la página, activa al servidor Elysia para renderizar el HTML y transferir el contenido de las páginas por completo.
En comparación: mientras que un sitio hecho en React te hace descargar como mínimo 2 megabytes de JavaScript (eso es el Bundle), en el sitio de este portafolio descargas apenas 50 kilobytes, provenientes de HTMX.
Además de la optimización, la experiencia de desarrollo es comparable a la de desarrollar en React, ya que se utiliza JSX, pero con un enfoque más simple que evita todo el bloat de React o de los frameworks de front-end.
2.
cli-authenticator es un autenticador TOTP (2FA) para la terminal, hecho en Node.js puro. Los códigos aparecen en cuanto se abre el CLI, y las cuentas nuevas entran desde una captura de un código QR, un archivo o la cámara, incluidas las exportaciones de Google Authenticator, que llegan divididas en varios códigos QR.
El foco fue la seguridad: los secretos viven en una bóveda cifrada con AES-256-GCM, con la clave derivada de la contraseña maestra vía scrypt y nunca guardada en disco. Todo lo que entra se trata como entrada no confiable: los archivos heredados se leen como texto (nunca se ejecutan), los nombres que vienen de códigos QR se sanean contra la inyección de secuencias de escape en la terminal, y los códigos copiados quedan fuera del historial del portapapeles.
La interfaz se dibuja solo con secuencias ANSI, sin framework de TUI, incluida la vista previa de la cámara, renderizada con medios bloques Unicode. La lectura de los códigos QR usa ZXing compilado a WebAssembly, ejecutándose localmente, y la cámara se accede mediante ffmpeg en Windows, macOS y Linux.
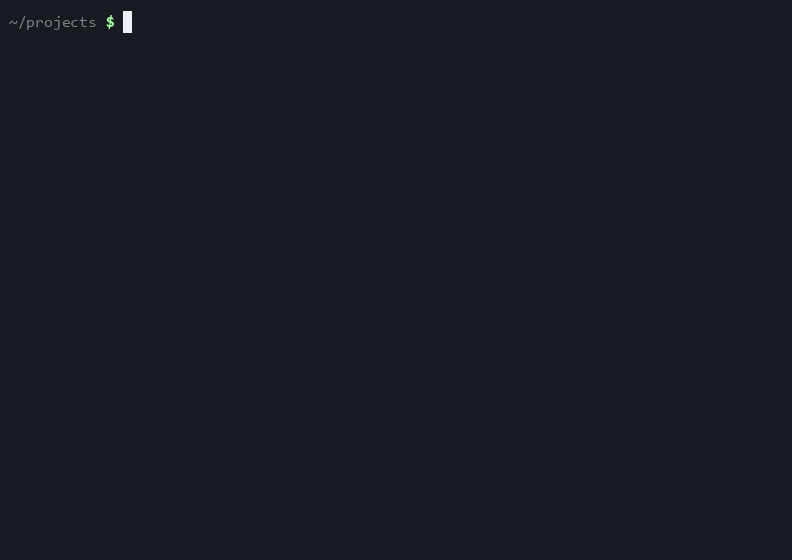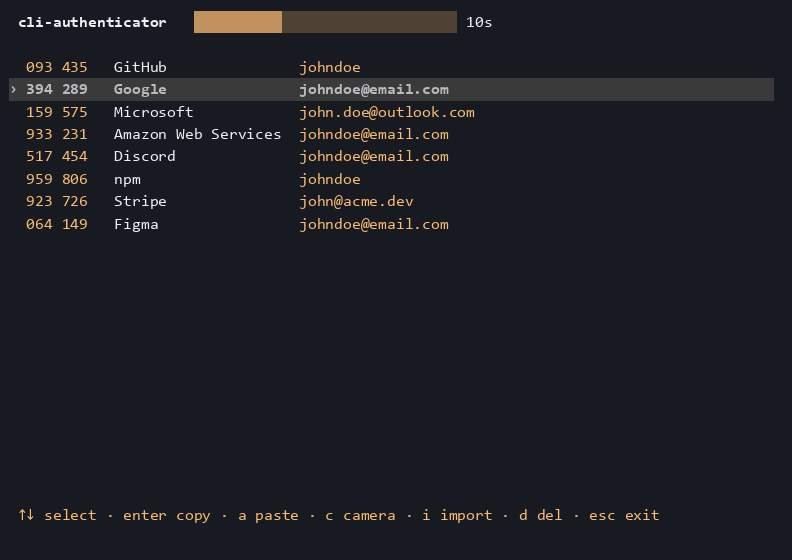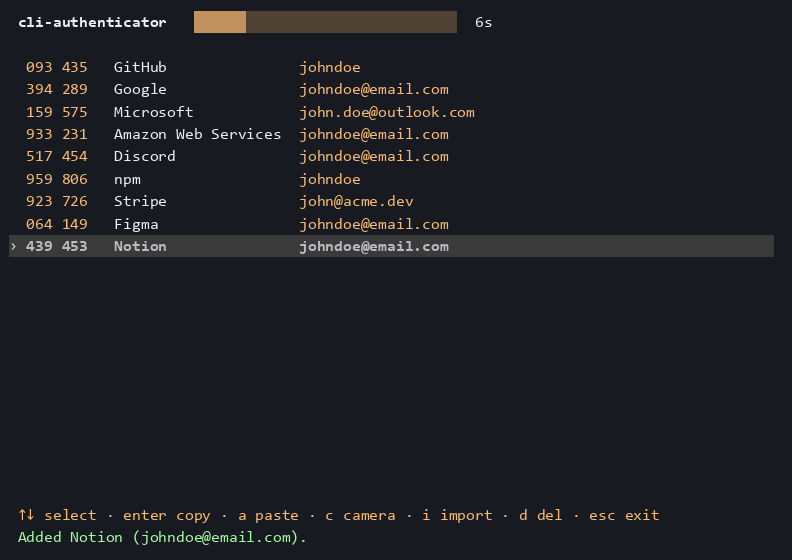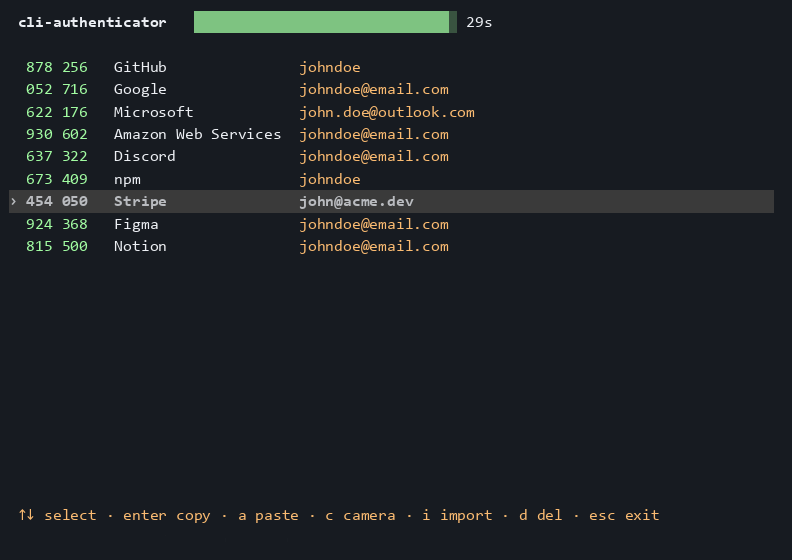
Cuentas y códigos ficticios, generados para la demostración.
3.
Gestor de Múltiples Agentes de Conversación Fluida es una plataforma para crear agentes conversacionales entrenados con tu propio contenido, integrada con múltiples LLMs y escrita en Elixir, con Phoenix y OTP. Es el proyecto que une mis conocimientos de back-end e IA, y una versión más simple del sistema de gestión y despliegue de chatbots que desarrollé para Elife.
La arquitectura es orientada a eventos: todo lo que ocurre en el sistema (un mensaje respondido, una llamada a un modelo, el progreso de un entrenamiento) se convierte en un evento en el PubSub de Phoenix. La persistencia, el conteo de tokens, los webhooks y un canal en vivo por WebSocket son suscriptores independientes, y una falla en uno de ellos no afecta a los demás.
Cada conversación corre en su propio proceso supervisado: los mensajes de un mismo usuario se procesan en orden, los de usuarios distintos en paralelo, el historial queda en memoria y los avisos de inactividad son timers del propio proceso, sin cron. Si el servidor se cae en medio de un entrenamiento, el coordinador reconstruye la cola desde la base de datos al volver a iniciar.
Responder y entrenar son pipelines componibles, declarados como una lista de pasos. Cada paso puede ser condicional, tener reintentos, correr con timeout en una tarea supervisada o en paralelo con otros (la detección de idioma y la búsqueda semántica corren al mismo tiempo), y los pasos se pueden reemplazar, insertar o quitar en tiempo de ejecución o por configuración.
Los modelos son intercambiables: cada uno se identifica como proveedor:modelo (OpenAI, Anthropic, Gemini o modelos locales con Ollama), y cambiar el modelo de un agente es un solo PATCH, incluso en medio de una conversación. Cada proveedor puede tener su propio rate limiting, con reintentos que respetan los límites de la API.
El RAG hace búsqueda semántica con embeddings en PostgreSQL con pgvector, y los agentes pueden llamar herramientas locales o de cualquier servidor MCP (por stdio o HTTP). La conversación se puede transferir a un agente humano cuando está integrada a un sistema externo, y la suite de tests corre sin base de datos ni red, con almacenamiento en memoria y un proveedor de modelos falso.
Tecnologías: Elixir, Phoenix, PostgreSQL + pgvector, Ollama y MCP.
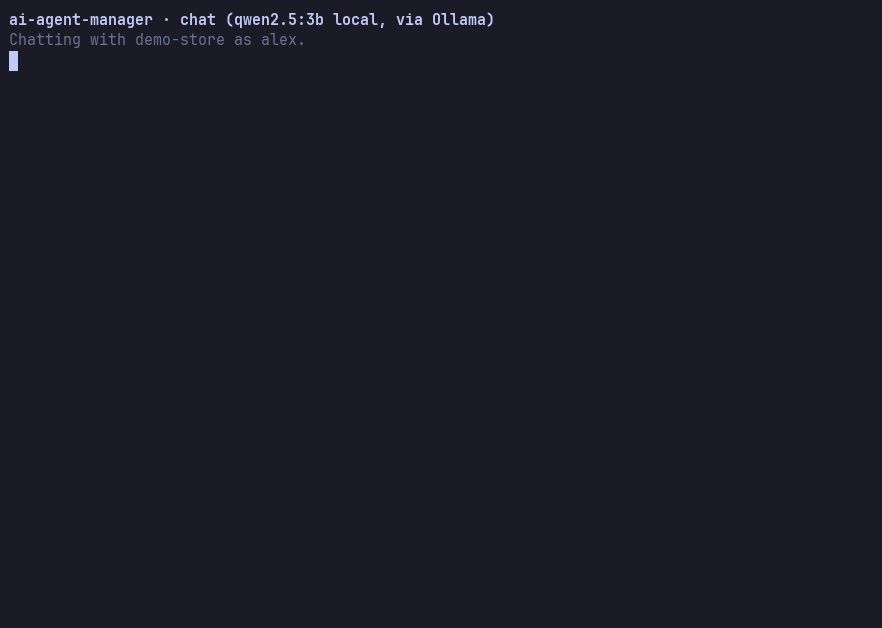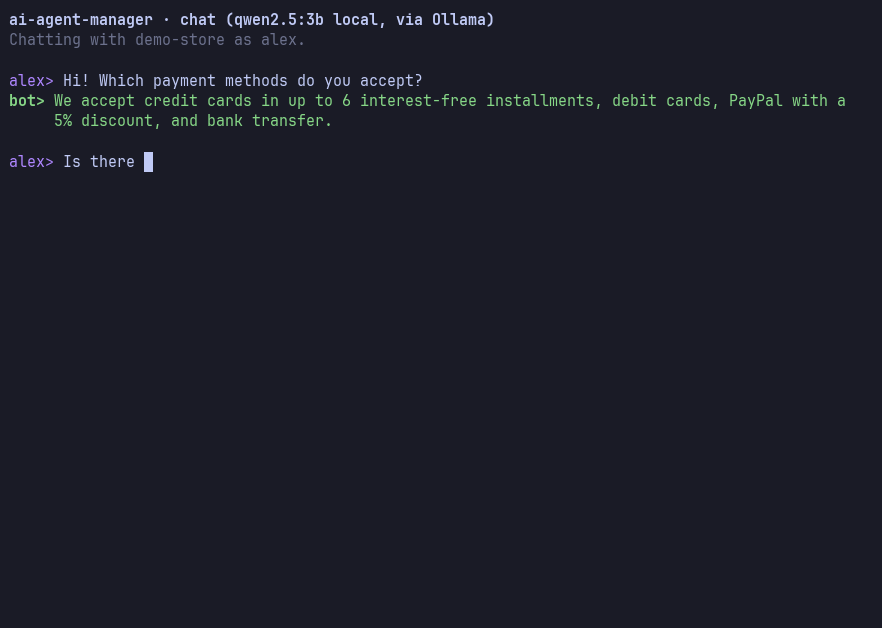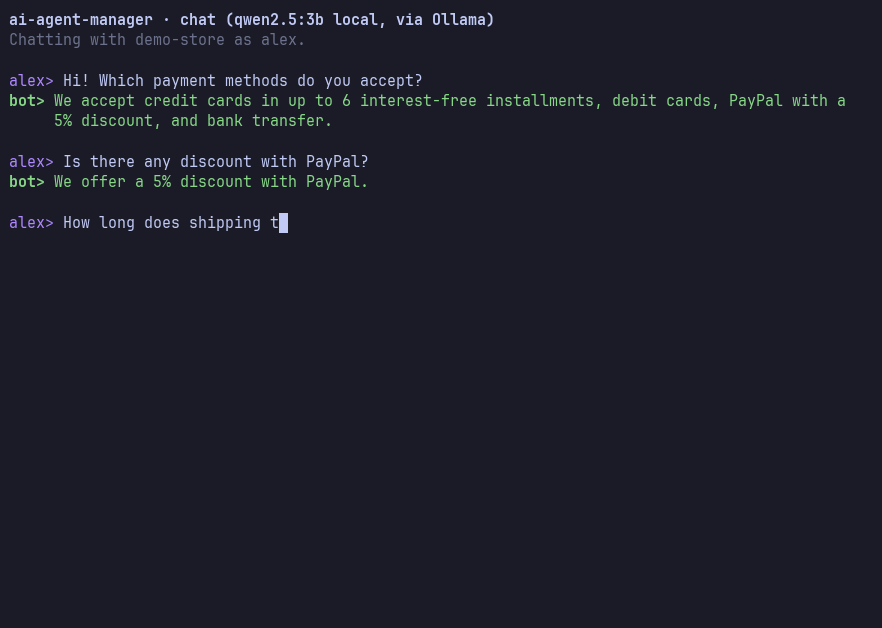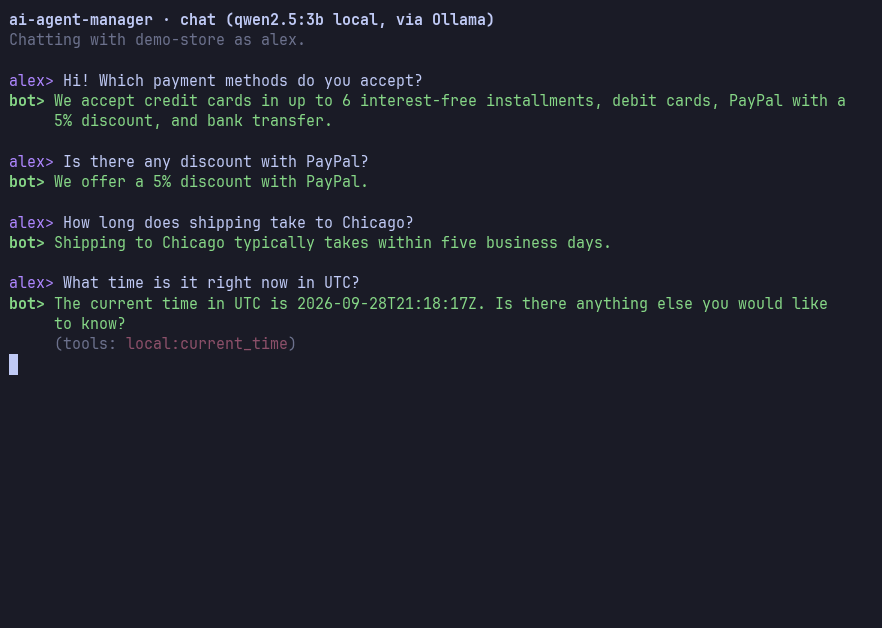
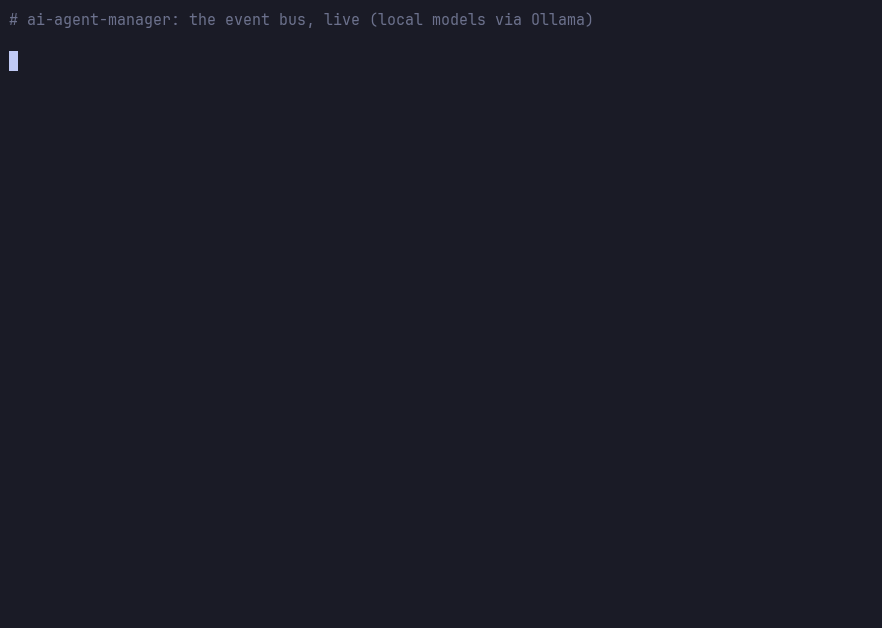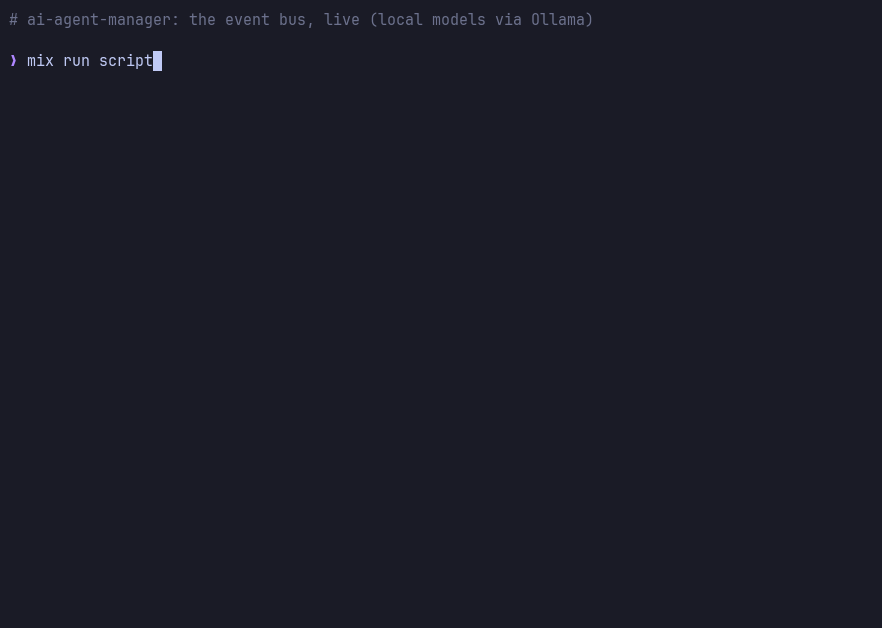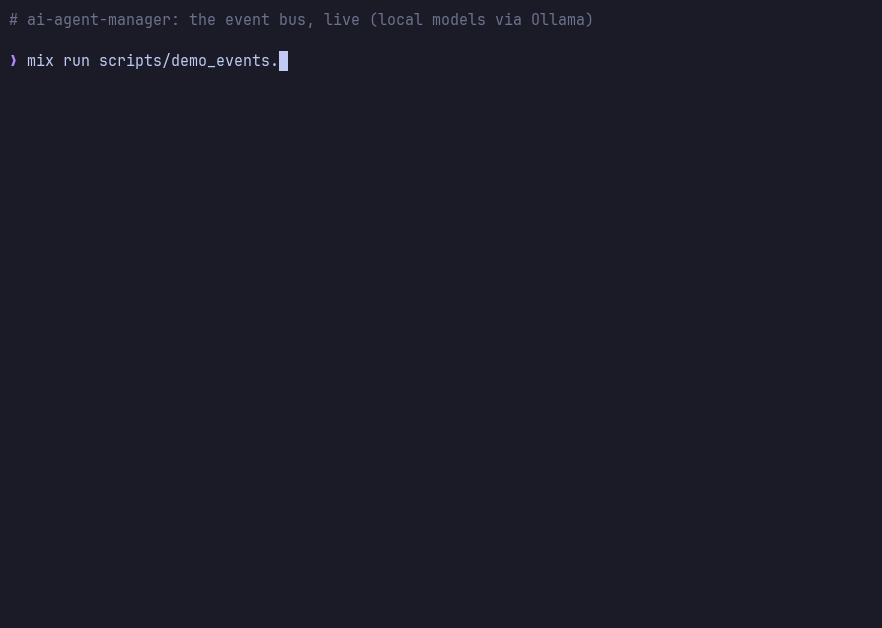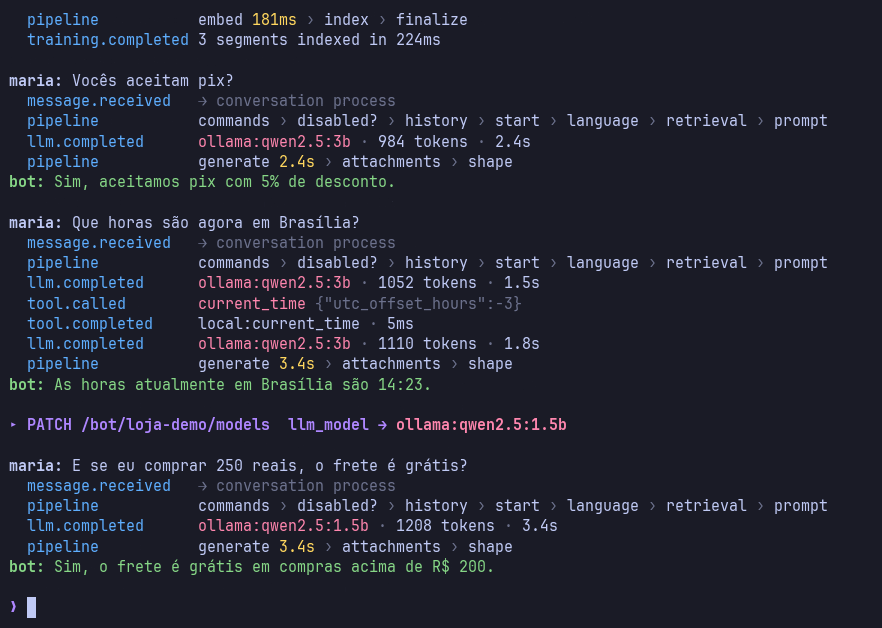
Grabaciones reales con modelos locales (qwen2.5 y embeddinggemma vía Ollama, en CPU); las esperas por el modelo se acortaron.
4.
Sistema de Control de Protocolos para la Administración Pública es un proyecto que surgió de dos becas de iniciación científica y fue finalizado e implementado como resultado de mi trabajo de fin de carrera en el IFPB.
En este proyecto pude usar el conocimiento que tenía en ese momento, basado en las tecnologías más nuevas para el lenguaje y las estructuras de datos. El sistema tuvo que manejar alto tráfico y alto rendimiento de procesamiento debido al alto uso del software. Todos los sectores de la alcaldía/dependencia pueden integrarse con la herramienta para tramitar protocolos de forma rápida y eficiente.
El sistema fue desarrollado usando la stack MERN. MongoDB, Express, Angular y Node.js. En la época del desarrollo inicial del software pude trabajar con la versión inicial de Angular.js (1.8.x, beta-2.x), y fue en este proyecto donde más pude perfeccionar mi formación full-stack, pues fue la primera vez que desarrollé front-end y back-end integrados para el mismo proyecto, al mismo tiempo.
5.
Sistema de Significado General de Palabras en línea fue un proyecto en el que fui becado con una beca de iniciación científica, donde el enfoque era la agrupación de significados lingüísticos.
Fue un sistema desarrollado para investigación lingüística compleja, que recopila información de varios sitios y la organiza automáticamente en un reporte más conciso para el investigador. También puso énfasis en facilitar la investigación para investigadores sordos, utilizando el sistema V-Libras, que convierte el reporte generado en un video de un personaje traduciendo el texto a la lengua de señas brasileña (Libras).
Este proyecto fue fundamentalmente un front-end que ejecutaba una serie de rutinas optimizadas de scraping en varios sitios. Se utilizó JavaScript puro para el enrutamiento de páginas, y Puppeteer e Cheerio para el scraping.
Más proyectos
¡Hablemos sobre mis otros proyectos y proyectos nuevos! Puedes encontrar formas de contactarme en la sección de Contacto.